Almacenamiento optimizado para IA: rendimiento, latencia y escalabilidad
Una empresa invierte en un clúster de GPU para entrenar sus modelos de inteligencia artificial. Tiene capacidad de procesamiento, buenas herramientas y muchos datos. En las primeras pruebas comprueba que las GPU pasan parte del tiempo esperando datos. El entrenamiento dura más de lo previsto y la inversión no rinde como se esperaba.
Los procesadores funcionan bien. Lo que falla es el almacenamiento, que no entrega la información a la velocidad que necesitan.
Este caso refleja un problema habitual en los proyectos de IA: de poco sirve tener potencia de cálculo si los datos no llegan a tiempo. Antes de ampliar el procesamiento, la pregunta que hay que hacerse es si el almacenamiento está preparado para lo que exige la IA.
Qué cambia la IA en el almacenamiento
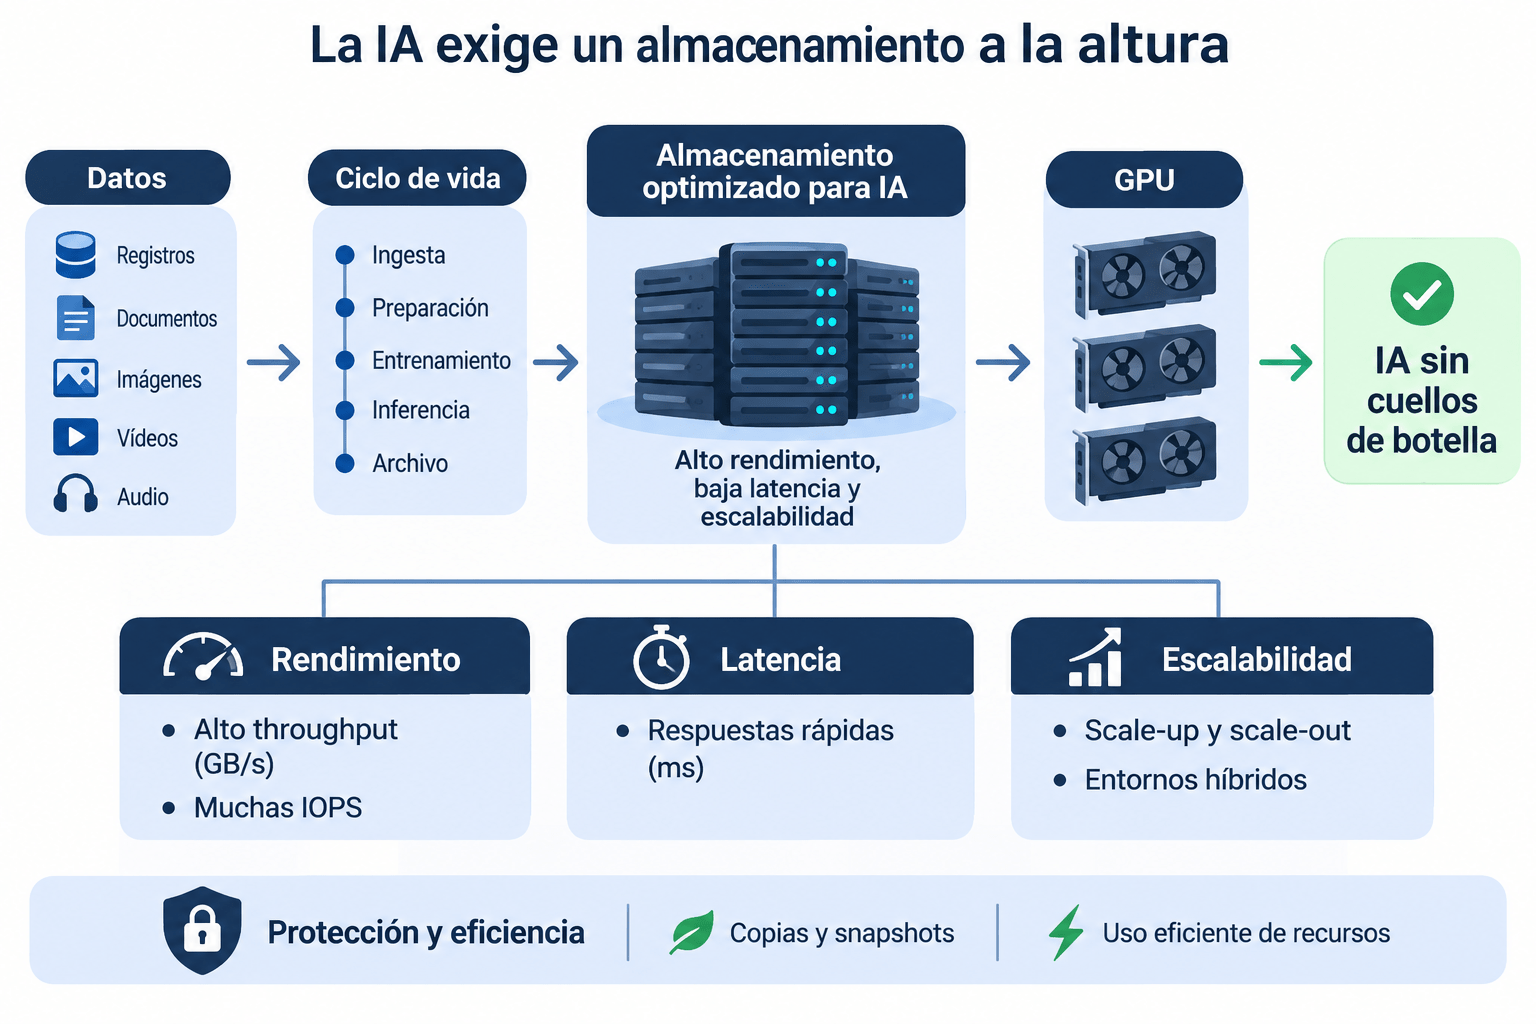
Muchas infraestructuras de almacenamiento empresariales están dimensionadas para aplicaciones, bases de datos y cargas de trabajo relativamente predecibles. La IA introduce exigencias adicionales: conjuntos de datos muy grandes, accesos simultáneos desde múltiples procesadores y operaciones intensivas de lectura y escritura. Además, los proyectos trabajan con datos de todo tipo: registros, documentos, imágenes, vídeos y audio.
Las necesidades también varían según la fase del ciclo de vida del dato. En la ingesta y la preparación se manejan grandes volúmenes. El entrenamiento requiere lecturas intensivas y en paralelo. En la inferencia puede ser decisivo acceder rápido a información adicional. En el archivo, lo que cuenta son la capacidad y el coste.
Una misma arquitectura tiene que cubrir todas estas necesidades sin convertirse en un cuello de botella.
Rendimiento: que las GPU no se queden esperando
El rendimiento del almacenamiento para IA se mide sobre todo con dos indicadores. El throughput mide la cantidad de datos transferidos por segundo, normalmente en MB/s o GB/s. Las IOPS indican cuántas operaciones de entrada y salida puede realizar el sistema por segundo. Cuál de los dos pesa más depende de la carga de trabajo.
En el entrenamiento, los modelos procesan grandes conjuntos de datos de forma continua. Si el almacenamiento no ofrece suficiente ancho de banda, las GPU esperan y las ejecuciones se alargan. En otras tareas, como la preparación de datos o la recuperación de muchos archivos pequeños, importa más poder hacer muchas operaciones a la vez.
También está el checkpointing, que guarda cada cierto tiempo el estado del entrenamiento para poder retomarlo si se interrumpe. Estas escrituras generan picos de actividad que la infraestructura tiene que absorber.
Para responder a estas necesidades, las arquitecturas actuales usan tecnologías como NVMe y NVMe over Fabrics (NVMe-oF), que dan acceso a dispositivos de alto rendimiento, locales o a través de una red. Usan también almacenamiento all-flash, con velocidades altas y tiempos de acceso reducidos, y sistemas de archivos paralelos, que reparten las operaciones entre varios nodos para atender muchas solicitudes. A ello se suma NVIDIA GPUDirect Storage, que permite transferir datos directamente entre el almacenamiento y la memoria de las GPU, evitando copias intermedias y reduciendo la carga sobre la CPU en configuraciones compatibles.
Aun así, instalar dispositivos más rápidos no garantiza por sí solo mejores resultados, porque la red, los servidores y la distribución de los datos también influyen.
Una forma de detectar problemas es analizar la utilización de las GPU. Si están inactivas mientras esperan nuevos lotes de datos, hay que revisar el recorrido completo de la información antes de invertir en más capacidad de cálculo.
Latencia: cuando cuentan los milisegundos
La latencia es el tiempo que pasa desde que una aplicación pide un dato hasta que empieza a recibirlo. Está relacionada con el rendimiento, pero no es lo mismo que el ancho de banda.
En el entrenamiento suele ser prioritario mantener un flujo de datos alto y constante. En algunas aplicaciones de inferencia, en cambio, pesan más los tiempos de respuesta. Un ejemplo es un sistema de detección de fraude que debe analizar una operación bancaria antes de autorizarla. Otro, un asistente de IA generativa que consulta documentación corporativa mediante una arquitectura RAG (Retrieval-Augmented Generation). En ambos casos, recuperar rápido la información necesaria reduce el tiempo total de respuesta.
Para conseguirlo, las empresas pueden usar memorias caché, colocar los datos más consultados cerca de los recursos de procesamiento y aplicar políticas de almacenamiento por niveles (tiering). La idea es evitar movimientos innecesarios de datos y reducir los tiempos de acceso. La latencia final depende además de la red, del procesamiento y de los propios modelos.
Escalabilidad: crecer sin rediseñar la infraestructura
Los proyectos de IA rara vez mantienen un volumen de datos constante. Al incorporar nuevas fuentes, modelos y aplicaciones, aumentan las necesidades de capacidad y de rendimiento. Por eso la escalabilidad debe planificarse desde el diseño inicial.
Las arquitecturas scale-up amplían los recursos de un sistema existente. Los modelos scale-out añaden nodos para aumentar la capacidad y, según la arquitectura, el rendimiento disponible. Este segundo enfoque es útil cuando muchos servidores necesitan acceder a la vez a grandes repositorios.
Todo se complica en entornos híbridos y multicloud, donde los datos pueden estar en centros de datos propios, en plataformas cloud o en dispositivos en el edge. No siempre es eficiente llevarlos todos a un único sitio. A veces es mejor acercar el procesamiento a donde están almacenados.
También hay que distinguir entre datos calientes, que se usan constantemente; templados, que se consultan de vez en cuando; y fríos, que se conservan sobre todo por motivos históricos o de cumplimiento. Si se asigna cada categoría al almacenamiento adecuado, se equilibran prestaciones y costes.
Protección y eficiencia
Los conjuntos de datos, los modelos entrenados y los resultados intermedios son activos valiosos. Perderlos o alterarlos puede obligar a repetir procesos costosos. Por eso, la estrategia de almacenamiento para IA debe incluir copias de seguridad, snapshots, mecanismos de inmutabilidad y procedimientos de recuperación.
La eficiencia energética también cuenta. Dimensionar bien los recursos y combinar tecnologías según las necesidades de cada fase evita inversiones innecesarias y un consumo de energía excesivo.
El almacenamiento forma parte de la estrategia de IA
Volvamos al clúster de GPU del principio. Ampliar su potencia no resolverá nada mientras siga esperando datos.
Para aprovechar las inversiones en inteligencia artificial, las empresas deben diseñar conjuntamente el procesamiento y el almacenamiento, equilibrando rendimiento, latencia, escalabilidad y costes. Porque disponer de GPU más potentes no garantiza mejores resultados si la infraestructura no es capaz de suministrarles los datos que necesitan, cuando los necesitan.